Música con IA en local para radio: modelos y producción propia
La oportunidad está en construir una identidad sonora propia, con mayor control técnico y una gestión documentada de los derechos.
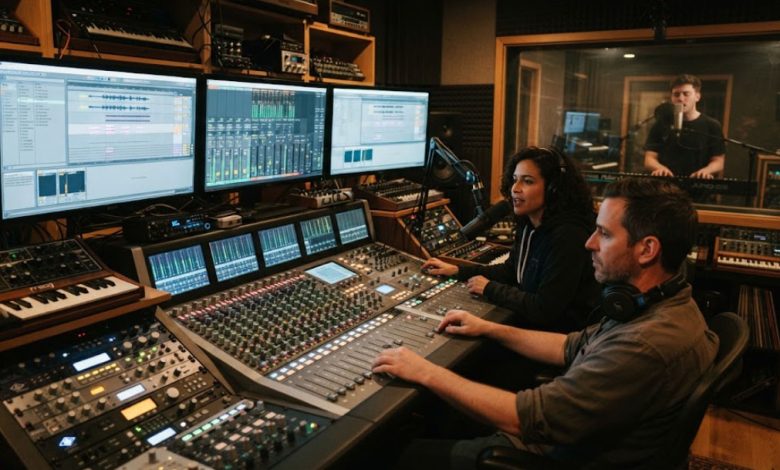
Los modelos musicales que se pueden instalar en un ordenador abren nuevas posibilidades para crear canciones, intros, promos, cortinillas y efectos.
Durante años, una emisora que necesitaba una cabecera, una base para sus promociones o una cortinilla tenía tres opciones habituales: contratar una producción, recurrir a una biblioteca musical o adaptar materiales de los que debía comprobar las condiciones de uso. La inteligencia artificial añade una cuarta vía: producir parte de ese material dentro del propio estudio.
El cambio va más allá de escribir una frase y recibir una canción. Los modelos descargables permiten experimentar con instrumentos, generar acompañamientos, transformar grabaciones y reconstruir fragmentos. Una radio puede plantearse un pequeño taller de producción sonora donde la IA genera material y el equipo decide qué merece convertirse en parte de su programación.
Para emisoras pequeñas, productores independientes, músicos y creadores de contenidos, esta evolución ofrece algo especialmente valioso: la posibilidad de desarrollar un catálogo que responda a sus necesidades concretas, en lugar de adaptar siempre sus ideas a lo que encuentran disponible.
Qué significa producir música con IA en local
Ejecutar un modelo en local significa descargar sus archivos y utilizar el procesador o la tarjeta gráfica del propio equipo para generar audio. El programa puede presentar una interfaz en el navegador, aunque el cálculo se realice en el ordenador.
Esto permite organizar sesiones sin consumir créditos de generación de una plataforma, conservar configuraciones y conectar la herramienta con otros procesos del estudio. A cambio, hay que asumir la instalación, el almacenamiento, el consumo eléctrico y el mantenimiento.
Conviene distinguir tres elementos: el código del programa, los pesos del modelo y la licencia aplicable a cada componente. Que un proyecto publique su código no implica que sus modelos permitan cualquier uso comercial. Tampoco significa que cualquier grabación introducida como referencia pueda reutilizarse libremente.
Tres proyectos que merece la pena conocer
ACE-Step 1.5 y XL: generación y edición en un mismo entorno
ACE-Step 1.5 reúne funciones de generación musical y edición. Su documentación enumera control de duración, tempo y tonalidad; edición de regiones mediante repainting; separación de pistas; generación de capas y creación de acompañamiento a partir de voces. La disponibilidad concreta depende del modelo y del modo de trabajo.
La familia incorpora variantes XL con un decodificador de 4.000 millones de parámetros. Sus autores indican un mínimo de 12 GB de VRAM utilizando descarga de componentes a la memoria del sistema, y recomiendan 20 GB o más. Para equipos modestos, las variantes de 2.000 millones de parámetros son un punto de partida más razonable.
Estas funciones permiten plantear trabajos como generar una base, añadir una capa o rehacer un pasaje que no encaja. No garantizan pistas perfectamente aisladas ni una interpretación exacta de todas las instrucciones: cada resultado necesita escucha y revisión.
La ficha de ACE-Step 1.5 identifica una licencia MIT y declara que permite utilizar comercialmente la música generada. Es una base favorable para producción propia, aunque no sustituye la comprobación del material aportado ni constituye una garantía universal contra reclamaciones.
Stable Audio 3: instrumentales, sonidos y edición de audio
Stable Audio 3 distingue modelos pequeños especializados en música o efectos y una variante Medium. Los modelos Small-Music y Small-SFX admiten hasta 120 segundos; Medium, hasta 380 segundos. Los pequeños disponen de ejecución en CPU, mientras que la ruta estándar de Medium utiliza GPU CUDA. La variante Large se ofrece mediante API y no forma parte de la instalación local de este repositorio.
Su arquitectura utiliza difusión en un espacio de audio comprimido: el sistema genera una representación interna y un decodificador la convierte en sonido. La familia admite generación a partir de texto, transformación de audio y edición o continuación de regiones.
Para una radio, esto se traduce en un campo amplio de experimentación con bases, ambientes, transiciones y efectos. Hay una limitación importante: la guía oficial indica que los modelos no producen voces inteligibles. Una textura vocal puede servir como recurso musical; una frase de identificación necesita otro sistema o una grabación humana.
HeartMuLa: letras y generación de canciones
HeartMuLa resulta interesante para explorar canciones condicionadas por letras y etiquetas musicales. La versión recomendada en su ficha pública es HeartMuLa-oss-3B-happy-new-year, identificada con licencia Apache 2.0.
El repositorio recomienda Python 3.10 y permite indicar archivos de letras y etiquetas. También incorpora carga bajo demanda para reducir la ocupación de memoria gráfica.
Es importante leer su estado de desarrollo: el repositorio mantiene como pendientes la versión abierta 7B y determinadas funciones de control anunciadas en la investigación. Las capacidades de un artículo científico no siempre están disponibles en el paquete descargable. Por eso, antes de elegirlo para un estudio, conviene comprobar el ejemplo oficial en el equipo que se utilizará.
Por qué la música electrónica es un buen terreno de trabajo
Desde una perspectiva de producción, la electrónica ofrece un punto de entrada muy útil: bases rítmicas, sintetizadores, secuencias, colchones ambientales y efectos pueden utilizarse como piezas modulares.
Un fragmento de veinte segundos puede convertirse en la apertura de un programa; una variación más tranquila, en una base para locución; un cierre contundente, en una cortinilla. Este enfoque permite aprovechar resultados que quizá no funcionarían como una canción completa.
La ventaja práctica no exige afirmar que todos los modelos son superiores en electrónica. Consiste en que sus recursos se prestan a la edición, la repetición y la combinación. Un pulso electrónico sencillo también deja espacio para la palabra, algo esencial en radio.
La prueba decisiva es escuchar el material con una voz encima. Una base espectacular por sí sola puede competir con el locutor, acumular demasiada energía en graves o incorporar cambios que distraen del mensaje.
Mucho más que canciones: una identidad sonora completa
La producción asistida por IA puede organizarse alrededor de necesidades concretas:
| Pieza | Aplicación en radio | Criterio de producción |
|---|---|---|
| Intro | Apertura de programa | Inicio reconocible y entrada clara de la voz |
| Cortinilla | Separación de bloques | Brevedad y cierre definido |
| Base de locución | Noticias, agenda o promociones | Arreglo discreto y estable |
| Jingle cantado | Identificación de la emisora | Nombre comprensible y melodía memorable |
| Efecto o transición | Cambios de sección | Sonido breve y función concreta |
| Tema completo | Espacio musical o contenido propio | Estructura, coherencia y acabado |
| Variaciones de una cabecera | Versiones de distinta duración | Motivo común y finales aprovechables |
El objetivo editorial puede ser construir una familia de sonidos: un mismo carácter musical con versiones para informativos, magazines, programación nocturna y redes sociales. Esa coherencia depende de la selección y del montaje.
Combinar voces e instrumentos: tres caminos diferentes
Generación conjunta. Un modelo de canciones puede producir voz cantada y acompañamiento a partir de letra y descripción. Es útil para probar jingles, aunque pueden aparecer errores de pronunciación o alteraciones del nombre de la emisora.
Acompañamiento de una grabación propia. ACE-Step documenta una función vocal a música de fondo. Una aplicación posible es explorar arreglos alrededor de una interpretación grabada por el equipo. Habrá que verificar sincronización, conservación de la voz y calidad del resultado en cada configuración.
Producción por capas. Para una promo hablada, el procedimiento más controlable suele ser generar el instrumental, grabar la locución por separado y montar ambos en un editor multipista. Así se corrige una fecha o un horario sin rehacer la música.
Separar voz e instrumental de una mezcla terminada tampoco equivale a recuperar las pistas originales de una sesión: pueden aparecer restos, pérdida de transitorios y artefactos. Los stems deben escucharse antes de reutilizarlos.
Qué ordenador hace falta
La VRAM es la memoria de la tarjeta gráfica; la RAM es la memoria general del ordenador. No son intercambiables, aunque algunas aplicaciones trasladan componentes a RAM para reducir la ocupación de la GPU.
La guía de ACE-Step establece Python 3.11 o 3.12, aproximadamente 10 GB de almacenamiento para modelos básicos y modos desde 4 GB de VRAM para el generador sin el modelo de lenguaje. También contempla CPU, Apple MPS, AMD ROCm e Intel XPU, con procedimientos específicos. Ejecutar en CPU puede ser considerablemente más lento.
Como orientación de planificación para un estudio —no como requisito oficial común a todos los modelos—, conviene disponer de SSD, 32 GB de RAM y margen de almacenamiento para modelos y exportaciones. Una GPU de 12 a 16 GB permite explorar más configuraciones que una de 4 GB, pero la elección debe hacerse después de verificar el modelo concreto.
Stable Audio 3 Small ofrece una vía para empezar sin una GPU dedicada. Para Medium, la documentación estándar añade Flash Attention 2, lo que exige prestar atención a la compatibilidad entre Python, PyTorch y CUDA.
No conviene confundir las demostraciones de velocidad publicadas por los desarrolladores con el rendimiento garantizado en cualquier PC. Duración, modelo, backend, memoria y configuración cambian el tiempo de generación.
Primera instalación: empezar con ACE-Step
Esta es una ruta introductoria basada en la guía oficial, adecuada para la configuración general con NVIDIA. AMD y otras plataformas deben seguir sus instrucciones específicas. Los comandos están documentados; no representan una instalación probada en el ordenador del lector.
Primero, instalar Git y el gestor de entornos uv mediante sus canales oficiales. Después, abrir una terminal y ejecutar:
git clone https://github.com/ACE-Step/ACE-Step-1.5.git
cd ACE-Step-1.5
uv sync
uv run acestep
La primera ejecución descarga los modelos. La interfaz se abre en:
http://localhost:7860Para la primera prueba, elegir una variante pequeña, generar un instrumental corto y comprobar que se puede exportar y abrir en el editor de audio. Después tiene sentido aumentar la duración o explorar funciones avanzadas.
La documentación también ofrece paquetes portables para Windows y macOS. El soporte AMD utiliza una ruta distinta; la guía advierte de que la instalación general puede sustituir un entorno ROCm por dependencias CUDA.
Otra entrada: generar una cortinilla con Stable Audio 3
Con Git y uv disponibles, el repositorio permite instalar el programa y utilizar su interfaz de línea de comandos:
git clone https://github.com/Stability-AI/stable-audio-3.git
cd stable-audio-3
uv sync
uv run stable-audio --model small-music -p "Electronic radio ident, warm synth pulse, crisp percussion, 110 BPM, instrumental" --duration 12 -o cortinilla.wav
Antes de descargar los pesos hay que aceptar las condiciones de acceso en Hugging Face y configurar la autenticación cuando corresponda. La ficha del modelo incorpora también condiciones de componentes Gemma. La ruta optimizada para CPU puede ser preferible en equipos sin GPU; está explicada en el repositorio.
El prompt es un ejemplo editorial: pedir una cortinilla no garantiza un final exacto ni un logotipo sonoro listo para emisión. El archivo necesita selección y montaje.
Cómo escribir instrucciones útiles
Una descripción eficaz expresa género, instrumentos, energía y función. Para una base de locución, también interesa pedir un arreglo poco denso.
Base para una agenda cultural:
Warm downtempo electronic instrumental, 95 BPM, soft percussion, rounded bass, gentle synth textures, sparse arrangement, understated mood, background bed for spoken radio.
Apertura de un programa nocturno:
Atmospheric electronic instrumental, slow pulse, spacious synthesizers, restrained bass, intimate late-night radio mood, gradual opening, short melodic motif.
Transición para noticias, utilizando un modelo de efectos:
Short broadcast transition, rising synthetic sweep, tight electronic impact, brief clean decay.
Estos ejemplos son propuestas de trabajo. Es preferible generar varias alternativas y modificar una variable cada vez. Si una idea funciona, guardar la semilla y los parámetros ayuda a repetir la configuración, aunque la reproducción exacta puede depender de la versión y del entorno.
La guía de Stable Audio recomienda describir instrumentos, tempo y carácter; para partes aisladas propone etiquetas como TrackType: Instrument. Solicitar un instrumento concreto aumenta el control, pero no garantiza una pista perfectamente limpia.
Del resultado de IA a una pieza lista para emisión
Un flujo práctico puede seguir seis pasos:
- Definir el encargo. Duración, uso, energía y punto de entrada de la voz.
- Generar alternativas. Buscar primero una idea útil, sin dedicar todo el tiempo a una única toma.
- Seleccionar y editar. Corregir silencios, cortes, finales y transiciones.
- Añadir la voz. Comprobar nombres, cifras, horarios y pronunciación.
- Mezclar y escuchar. Ajustar niveles, aplicar reducción de la música bajo la voz y revisar en mono, auriculares y altavoces.
- Archivar. Conservar el máster, los componentes, el prompt, el modelo y la licencia.
La reducción automática de la música mientras habla el locutor, conocida como ducking, puede realizarse con automatización de volumen o compresión controlada por la pista de voz. El criterio principal es que el mensaje se entienda sin esfuerzo.
Para conservar calidad, conviene trabajar con archivos sin pérdidas cuando el sistema permita exportarlos, evitar sucesivas compresiones a MP3 y adaptar el máster al procesamiento de la emisora.
Producción propia y licencias: dónde está la ventaja real
La expresión «música sin problemas de licencias» necesita una precisión: la IA local puede reducir la dependencia de repertorios ajenos, pero no elimina automáticamente los derechos ni las condiciones de uso.
ACE-Step presenta condiciones favorables al uso comercial. HeartMuLa identifica su modelo recomendado con Apache 2.0. Stable Audio 3 tiene código MIT, pero sus pesos se rigen por una licencia diferente.
La licencia incluida en Small-Music contempla uso comercial gratuito dentro de sus condiciones para personas u organizaciones por debajo del umbral indicado de un millón de dólares de ingresos anuales, exige registro para uso comercial y establece una vía empresarial al superar el límite. El cómputo incluye afiliadas y no se limita a los ingresos obtenidos con la IA. También distingue los resultados del modelo de los materiales del propio sistema y no garantiza ausencia de infracción.
Para trabajar con criterio, deben separarse cuatro cuestiones: permiso para utilizar el modelo, derechos sobre audios de entrada, autorización para utilizar una voz y derechos sobre el resultado final.
Introducir una canción comercial para transformarla no la convierte automáticamente en música propia libre de obligaciones. Del mismo modo, una licencia del modelo no autoriza a clonar la voz de otra persona. La posibilidad de atribuir derechos exclusivos al resultado dependerá de la legislación y de la aportación creativa humana.
Una buena práctica es crear una ficha por producción: versión del modelo, licencia conservada, fecha, audios aportados, autorizaciones de voz y trabajo de edición. Esta documentación ayuda a gestionar un catálogo propio.
Qwen 3.8 27B: un asistente para construir herramientas musicales
Junto a los generadores de audio existe otra categoría de IA útil en el estudio: los modelos que ayudan a escribir, programar y organizar la producción. Qwen3.8-27B pertenece a este grupo. Su ficha oficial describe un modelo de 27.000 millones de parámetros, con comprensión de imágenes y vídeo, capacidades de programación y licencia Apache 2.0. Su contexto nativo es de 262.144 tokens, ampliable mediante configuración; eso no implica que cualquier ordenador pueda utilizar el máximo con fluidez.
Su función musical consiste en trabajar con instrucciones, datos y código. No debe confundirse con un generador directo de canciones ni atribuirle entrada o salida de audio por el hecho de ser multimodal. Tampoco corresponde trasladarle capacidades de otras variantes Omni sin comprobar el modelo concreto.
Como aplicación propuesta de sus capacidades de programación, puede ayudar a desarrollar un sintetizador sencillo, un secuenciador o efectos mediante JavaScript y Web Audio API. En este caso, Qwen escribe el programa y es el motor de audio el que produce el sonido.
También puede asistir en scripts que crean MIDI: notas, duraciones, velocidades y cambios de instrumento. El MIDI contiene instrucciones musicales; para escucharlo hace falta un instrumento virtual o sintetizador. Esta vía permite editar con precisión un motivo breve de identificación.
Por ejemplo, se le podría pedir:
Escribe un script Python que cree un MIDI de ocho compases a 110 BPM, con una progresión original en la menor y una melodía sencilla. Explica cómo modificar las notas y exportarlo para abrirlo en un editor musical.
Otra aplicación propuesta es revisar letras, sugerir estructuras y preparar prompts para un generador de audio. Puede recibir notas MIDI convertidas a datos legibles, pero no hay que asumir que interpretará correctamente un archivo binario pegado como texto. Las propuestas armónicas y métricas requieren revisión musical.
Para vídeos, puede ayudar a elaborar guiones visuales a partir de escenas y tiempos proporcionados. Sincronizar cortes con golpes musicales exige además análisis de audio y herramientas de edición: no es una función demostrada del modelo por sí solo.
Cómo empezar en local con Qwen
Ollama publica una variante de aproximadamente 18 GB y documenta su ejecución. Con Ollama instalado y actualizado, puede iniciarse desde una terminal:
ollama run qwen3.8:27bEl tamaño descargado no equivale a toda la memoria necesaria. Hay que añadir memoria de ejecución, contexto y, según el uso, componentes visuales. Como orientación de planificación, 32 GB de memoria general o unificada ofrecen más margen que 16 GB; una carga de trabajo amplia puede necesitar bastante más. El rendimiento depende de la cuantización, el contexto y de cuánto cálculo se realice en GPU.
Para el estudio, conviene empezar con conversaciones cortas y tareas delimitadas. Si Qwen y el generador musical utilizan la misma GPU, ejecutarlos por turnos puede evitar que compitan por memoria.
Plataformas externas: producir sin instalar modelos
La producción local puede convivir con servicios externos. Una plataforma alojada permite comenzar sin configurar modelos ni disponer de una GPU potente, a cambio de depender de sus planes, límites, exportaciones y licencias.
Suno: canciones, jingles y material para edición
Suno es una opción para trabajar con canciones con voz y convertir una letra breve en material musical. Como propuesta para radio, puede utilizarse para explorar identificaciones cantadas y producir una pieza más larga de la que extraer diferentes fragmentos.
Conviene pedir frases breves y comprobar especialmente el nombre de la emisora. Un buen arreglo no compensa una identificación mal pronunciada.
La ayuda actual de Suno indica que las canciones descargadas mientras se dispone de una suscripción de pago reciben derechos de uso comercial, aunque esto no garantiza protección por derechos de autor. Otra página advierte de que suscribirse no concede automáticamente derechos retroactivos a las canciones realizadas con el plan gratuito.
Además, su documentación anuncia límites aplicables desde septiembre de 2026: 20 descargas mensuales en Pro y 60 en Premier, con un tratamiento distinto para el trabajo en Studio. Generar y descargar son operaciones con límites diferentes. Para una emisora, conviene conservar el archivo, el justificante del plan y las condiciones aplicables a la pieza.
Udio: verificar la exportación antes de elegirlo
Udio merece atención dentro de la generación musical, pero su utilidad para radio depende de poder extraer el resultado. La página oficial consultada indica que se han deshabilitado las descargas de audio, vídeo y stems tras los cambios asociados a su acuerdo con Universal Music Group.
Esta restricción impide recomendarlo como fuente directa de archivos para el automatizador mientras siga vigente. La situación debe comprobarse de nuevo al contratar, porque una buena experiencia dentro de la plataforma no asegura un flujo de producción exportable.
Mubert y SOUNDRAW: música para acompañar contenidos
Mubert permite trabajar con fondos musicales y ajustar elementos como duración y, según el plan, estructura, tempo y pistas. Su oferta distingue usos comerciales y no comerciales. También prohíbe redistribuir los resultados como música independiente o publicarlos en plataformas musicales como Spotify. Para radio, debe confirmarse que la licencia elegida cubra la modalidad de emisión prevista.
SOUNDRAW distingue música de acompañamiento y producción de canciones a partir de sus bases. Su página de licencias incluye radio entre los usos permitidos y establece condiciones adicionales para distribuir canciones: en los planes Artist, la base debe modificarse para obtener una pieza claramente diferente. También prohíbe el registro en Content ID.
En ambos casos, “royalty-free” describe un régimen de licencia; no significa dominio público ni libertad para cualquier explotación.
AIVA: composición y trabajo con MIDI
AIVA permite generar y editar composiciones y utilizar influencias de audio o MIDI. Es una alternativa a explorar para cabeceras instrumentales y enfoques orquestales o cinematográficos.
La exportación MIDI permite llevar la composición a un editor y escoger instrumentos, cambiar notas o rehacer el arreglo. Sus planes tienen condiciones distintas: el gratuito es no comercial, Standard limita la monetización a determinadas plataformas y Pro ofrece condiciones más amplias. Una radio no debe asumir que cualquier suscripción cubre la emisión.
LALAL.AI: separación y limpieza del material
LALAL.AI ocupa otra parte del proceso: separación de voz e instrumentos, limpieza de grabaciones y reducción de eco o reverberación. Puede servir para preparar componentes de una producción propia antes del montaje.
La calidad de separación depende del archivo y de la mezcla; pueden aparecer restos de otras pistas. Extraer una voz o una batería tampoco cambia los derechos de la grabación de origen.
Un estudio híbrido: elegir la herramienta según el encargo
| Necesidad | Herramienta o enfoque que explorar |
|---|---|
| Letras, prompts, código y MIDI | Qwen como asistente de trabajo |
| Canciones y jingles cantados | Generadores musicales locales o Suno |
| Bases y efectos propios | Stable Audio 3 y otras herramientas locales |
| Música de acompañamiento licenciada | Mubert o SOUNDRAW, según el uso permitido |
| Composición instrumental editable | AIVA y posterior trabajo en MIDI |
| Separación y limpieza | LALAL.AI u otras herramientas especializadas |
| Promo hablada lista para emisión | Locución separada y mezcla en un editor |
Nuestra propuesta para una emisora pequeña es combinar funciones: preparar el encargo con un asistente, generar o componer la música con una herramienta adecuada y terminar la pieza en el editor de audio.
El criterio de elección debería ser práctico: calidad del resultado, tiempo de trabajo, posibilidad de exportación, control de la edición y licencia para el uso previsto. Tener varias herramientas resulta útil cuando cada una resuelve una necesidad concreta del estudio.
La oportunidad para las emisoras pequeñas
Nuestra valoración es que el mayor beneficio inicial está en las piezas de uso diario: bases, promos, separadores y cabeceras. Son trabajos delimitados, fáciles de evaluar y con una utilidad inmediata.
Una radio puede comenzar con una cabecera, dos cortinillas y una base para locución. Si comparten un motivo y un carácter reconocible, ese pequeño conjunto ya aporta identidad. Después puede ampliarlo con versiones estacionales, formatos para redes o proyectos musicales completos.
La tecnología acerca herramientas antes costosas, pero la calidad sigue dependiendo de decisiones humanas: qué sonido representa a la emisora, qué emoción conviene a cada espacio y cuándo la música debe dejar sitio a la palabra.
La nueva era de la producción radiofónica propia consiste en poder diseñar, probar y construir el sonido de una emisora desde su estudio, con más autonomía y con un proceso técnico y documental que permita utilizarlo con confianza.
Fuentes y documentación
- ACE-Step 1.5: funciones y variantes XL
- ACE-Step 1.5: ficha del modelo y licencia
- Stable Audio 3: modelos, requisitos y uso
- Stable Audio 3 Small-Music: ficha y acceso
- Stable Audio 3: guía de prompts y limitaciones vocales
- HeartMuLa: modelo recomendado y licencia
- HeartMuLa: instalación y estado del proyecto
- ACE-Step: guía oficial de instalación
- Licencia incluida en Stable Audio 3 Small-Music
- Qwen3.8-27B: ficha oficial
- Qwen3.8 en Ollama
- Suno: derechos con suscripción
- Suno: derechos de canciones anteriores
- Suno: cambios en descargas
- Udio: cambios y descargas
- Mubert: planes y restricciones
- SOUNDRAW: licencias
- AIVA: funciones y planes
- LALAL.AI: separación y limpieza